System WMS nie jest jednym programem, tylko zestawem współpracujących warstw. Baza danych przechowuje dane magazynowe, warstwa aplikacji odpowiada za logikę biznesową i interfejs, a osobne moduły obsługują kolejne etapy procesu magazynowego. Do tego dochodzą integracje oraz sprzęt na hali, a także mechanizmy bezpieczeństwa. Artykuł opisuje architekturę oprogramowania WMS od środka, z myślą o osobie, która ocenia system technicznie.
Zakres funkcji, czyli to, co system robi w kolejnych operacjach, opisuje osobny tekst o oprogramowaniu WMS i jego funkcjach. Tutaj ważne jest, z czego ten system jest zbudowany i gdzie leżą jego ograniczenia.
Architektura oprogramowania WMS w czterech warstwach
Zestawienie pokazuje, jaką rolę pełni każda warstwa i jakie ryzyko pojawia się, gdy jest źle zaprojektowana. Technologie w trzeciej kolumnie są przykładowe, bo konkretny system może używać innych.
| Warstwa | Zadanie | Przykładowa technologia | Typowe ryzyko |
|---|---|---|---|
| Dane | Kartoteki, dokumenty, stany, historia operacji | Microsoft SQL Server, T-SQL | Wolne raporty na tabelach operacyjnych |
| Logika biznesowa | Rezerwacje, statusy, reguły dokumentów | C# na serwerze aplikacji | Reguły rozproszone po stacjach roboczych |
| Interfejs | Ekrany biurowe i terminale na hali | Aplikacja desktopowa, przeglądarka, Android | Aktualizacje na każdym komputerze osobno |
| Integracje | Wymiana z ERP, sprzedażą, transportem | REST, SOAP, pliki, kolejki | Utrata dokumentów przy awarii łącza |
Reguła: reguły biznesowe wykonują się w jednym miejscu, na serwerze. Logika rozsiana po stacjach roboczych sprawia, że ten sam dokument bywa liczony inaczej na dwóch komputerach.
W Studio WMS.net dane leżą w bazie Microsoft SQL Server, a klienci łączą się z serwerem aplikacji, nie bezpośrednio z bazą. Wymagania środowiska dla administratora zestawia strona o specyfikacji technicznej programu WMS.net.
Warstwa bazy danych w systemie WMS
Schemat danych magazynowych
Rdzeniem systemu jest baza danych z osobnymi tabelami dla kartotek asortymentowych i dokumentów, a także dla lokalizacji oraz uprawnień. Tabele łączą klucze obce, więc dokument nie może wskazać nieistniejącego towaru, a ruch magazynowy nie może odwoływać się do usuniętej lokalizacji. Silnik SQL Server zapewnia transakcje o gwarantowanej spójności i przyzwoitą wydajność przy wielu jednoczesnych zapisach.
Różnica między danymi operacyjnymi a historycznymi decyduje o wydajności. Na tabelach operacyjnych pracują skanery i terminale w czasie rzeczywistym, a raporty roczne czytają miliony wierszy ruchów. Jeśli oba obciążenia trafiają w te same indeksy, raport potrafi zatrzymać kompletację.
Indeksy dla terminali i raportów
Indeks filtrowany obejmuje tylko wiersze spełniające warunek, na przykład zadania o statusie OCZEKUJE, więc pozostaje mały, a wyszukiwanie kolejnego zadania nie skanuje całej tabeli. Indeks pokrywający zawiera kolumny potrzebne zapytaniu, dzięki czemu baza nie sięga do tabeli po resztę danych. Poniższy przykład tworzy jeden i drugi. Nazwy tabel i kolumn są wyłącznie ilustracją.
-- przykład: indeks filtrowany pod kolejkę zadań, z której korzystają terminale
CREATE NONCLUSTERED INDEX IX_Zadanie_Otwarte
    ON dbo.ZadanieMagazynowe (IdStrefy, Priorytet DESC, TerminWysylki)
    INCLUDE (KodLokalizacji, Indeks, Ilosc)
    WHERE Status = 'OCZEKUJE';

-- przykład: osobny indeks pod raporty historyczne, żeby nie obciążać tabeli operacyjnej
CREATE NONCLUSTERED INDEX IX_Ruch_Raport
    ON dbo.RuchMagazynowy (DataRuchu, Indeks)
    INCLUDE (Ilosc, TypRuchu);
Zasady projektowania indeksów opisuje dokumentacja indeksów w SQL Server w Microsoft Learn. W praktyce każdy dodatkowy indeks przyspiesza odczyt i spowalnia zapis, więc liczbę indeksów na tabelach operacyjnych trzyma się na rozsądnym poziomie.
Blokady i poziom izolacji
Kiedy terminale zapisują ruchy, a kierownik uruchamia raport, obie operacje sięgają do tych samych tabel. Przy domyślnym poziomie READ COMMITTED odczyt czeka na zatwierdzenie zapisu, który trzyma blokadę wiersza, więc długi raport potrafi spowolnić skanowanie na hali. Opcja READ_COMMITTED_SNAPSHOT zmienia to zachowanie: odczyty korzystają z poprzedniej, zatwierdzonej wersji wiersza i nie czekają na zapisy. Kosztem jest dodatkowe miejsce na wersje wierszy w bazie tempdb.
-- przykład: odczyty oparte na wersjach wierszy, wykonywane w oknie serwisowym
ALTER DATABASE Magazyn SET READ_COMMITTED_SNAPSHOT ON WITH ROLLBACK IMMEDIATE;
Zmiana wymaga wyłącznego dostępu do bazy na moment przełączenia, dlatego robi się ją poza godzinami pracy magazynu. Pełny opis poziomów izolacji i wersjonowania wierszy znajduje się w przewodniku po blokadach i wersjonowaniu wierszy.
Archiwizacja danych historycznych
Z upływem lat baza rośnie, bo nic w niej nie znika: dokumenty oraz historia ruchów zostają. Bez archiwizacji raporty i operacje bieżące zwalniają zauważalnie. Podstawowy krok polega na wydzieleniu danych starszych niż przyjęty okres do osobnych struktur, do których sięga się rzadko. Tabele partycjonowane pozwalają zrobić to bez zmiany sposobu odczytu, co opisuje dokumentacja tabel i indeksów partycjonowanych.
Warstwa aplikacji - klient-serwer czy przeglądarka
Nad bazą działa warstwa aplikacji, w której wykonuje się logika biznesowa, a użytkownik widzi interfejs. Systemy WMS budowane są w jednym z dwóch modeli: jako aplikacja kliencka instalowana na stacji roboczej albo jako aplikacja webowa dostępna w przeglądarce. Wybór wpływa na instalację i aktualizacje oraz na dostęp zdalny. Wariant desktopowy Studio WMS.net opisuje strona o Magazyn Framework, a wersję przeglądarkową strona o aplikacji internetowej WMS.
Architektura klient-serwer
W klasycznym układzie aplikacja instalowana lokalnie łączy się z serwerem w sieci magazynu. Zapewnia to niską latencję operacji i pełne wykorzystanie zasobów stacji, co ma znaczenie przy pracy wielookienkowej i zestawieniach z dużą ilością danych. Wadą jest konieczność instalowania i aktualizowania oprogramowania na każdym stanowisku, co przy większej liczbie komputerów angażuje dział IT.
Architektura webowa
W modelu webowym aplikacja działa na serwerze, a użytkownik łączy się z nią przez przeglądarkę. Przeglądarka wysyła żądania asynchroniczne (AJAX) i odświeża tylko fragment ekranu, a nową wersję programu wdraża się raz, po stronie serwera. Serwer może stać w firmie albo u dostawcy infrastruktury, a wybór między tymi wariantami omawia strona o programie magazynowym w chmurze i on-premise.
| Kryterium | Klient-serwer | Architektura webowa |
|---|---|---|
| Instalacja na stacji | Wymagana na każdym stanowisku | Niepotrzebna, wystarczy przeglądarka |
| Aktualizacja wersji | Osobno na każdym komputerze | Jednorazowo na serwerze |
| Praca z wielu lokalizacji | Wymaga dodatkowej konfiguracji sieci | Wystarczy dostęp do Internetu |
| Zestawienia z dużą ilością danych | Korzystają z zasobów stacji roboczej | Zależą od serwera i łącza |
| Koszt utrzymania stanowisk | Wyższy, obsługa IT po stronie klienta | Niższy, zarządzanie centralne |
Żaden z modeli nie jest lepszy w każdych warunkach. O tym, który z nich się opłaca, rozstrzyga liczba stanowisk i rozproszenie magazynów oraz zasoby działu IT.
Moduły funkcjonalne jako odrębne komponenty
Nad warstwą aplikacji system dzieli się na moduły odpowiadające kolejnym etapom procesu. Każdy moduł jest wymiennym komponentem, który można włączyć lub wyłączyć, a także skonfigurować bez ingerencji w rdzeń. Podział pozwala uruchomić na starcie tylko funkcje potrzebne w danym magazynie, a resztę dołączać etapami, wraz z rozwojem firmy, bez wymiany całego systemu.
| Moduł | Zadanie | Główne dane |
|---|---|---|
| Przyjęcia | Rejestracja dostaw, zgodność z awizacją, przydział do lokalizacji | Dostawy, pozycje, różnice |
| Składowanie | Mapa lokalizacji i stany w czasie rzeczywistym | Lokalizacje, statusy, zawartość |
| Kompletacja i wysyłka | Trasy zbierania i dokumenty wydania | Zadania, rezerwacje, WZ |
| Dokumenty | Elektroniczne dokumenty magazynowe z historią zmian | Nagłówki i pozycje dokumentów |
| Raportowanie | Zestawienia operacyjne i definicje raportów | Ruchy i zadania z czasem operacji |
Raporty i wydruki dokumentów opierają się zwykle na definicjach zapisanych w bazie. Sposób ich tworzenia w SSRS opisuje strona o SQL Report Builder, a dostęp do funkcji zależy od ról, które omawia artykuł o rolach i użytkownikach w systemie WMS.
Integracje i interfejsy API
System WMS rzadko pracuje w izolacji. Wymienia dane z ERP i platformą sprzedażową, a także z systemem transportowym oraz kolektorami danych. Podstawowym mechanizmem jest API oparte na usługach webowych, uzupełnione gotowymi konektorami do popularnych ERP. Integrację da się wtedy wdrożyć bez zmiany kodu WMS, konfigurując mapowanie pól i harmonogram synchronizacji.
Najważniejsze pytanie projektowe brzmi, co się dzieje, gdy jeden z systemów jest niedostępny. Odpowiedzią jest kolejka: komunikat zapisuje się w tabeli, a osobne zadanie próbuje go dostarczyć i zwiększa licznik prób. Przykład pokazuje uproszczoną strukturę takiej kolejki.
-- przykład: kolejka wymiany z ERP z licznikiem prób (nazwy są ilustracją)
CREATE TABLE dbo.KolejkaWymiany (
    IdKomunikatu bigint IDENTITY(1, 1) PRIMARY KEY,
    Typ varchar(30) NOT NULL,
    Tresc nvarchar(max) NOT NULL,
    Status varchar(12) NOT NULL DEFAULT 'NOWY',
    Proby int NOT NULL DEFAULT 0,
    DataUtworzenia datetime2 NOT NULL DEFAULT SYSDATETIME(),
    DataOstatniejProby datetime2 NULL
);
Bez takiego zabezpieczenia jedna przerwa w łączności z ERP potrafi wygenerować różnice w stanach, które wyjaśnia się dopiero po kilku dniach. Szczegóły protokołów i obsługi błędów opisuje strona o integracji WMS z ERP.
Sprzęt i infrastruktura hali
Architektura obejmuje także warstwę fizyczną. Serwer bazy danych powinien mieć zasoby dobrane do przewidywanej liczby dokumentów i użytkowników, z zapasem na wzrost przez kilka lat. Po stronie hali podstawowe znaczenie ma zasięg sieci bezprzewodowej w każdej strefie, także tam, gdzie sygnał jest słabszy, czyli przy wysokich regałach i w chłodniach. Terminale łączą się z aplikacją tą samą siecią, więc każda przerwa w łączności zatrzymuje pracę magazynu.
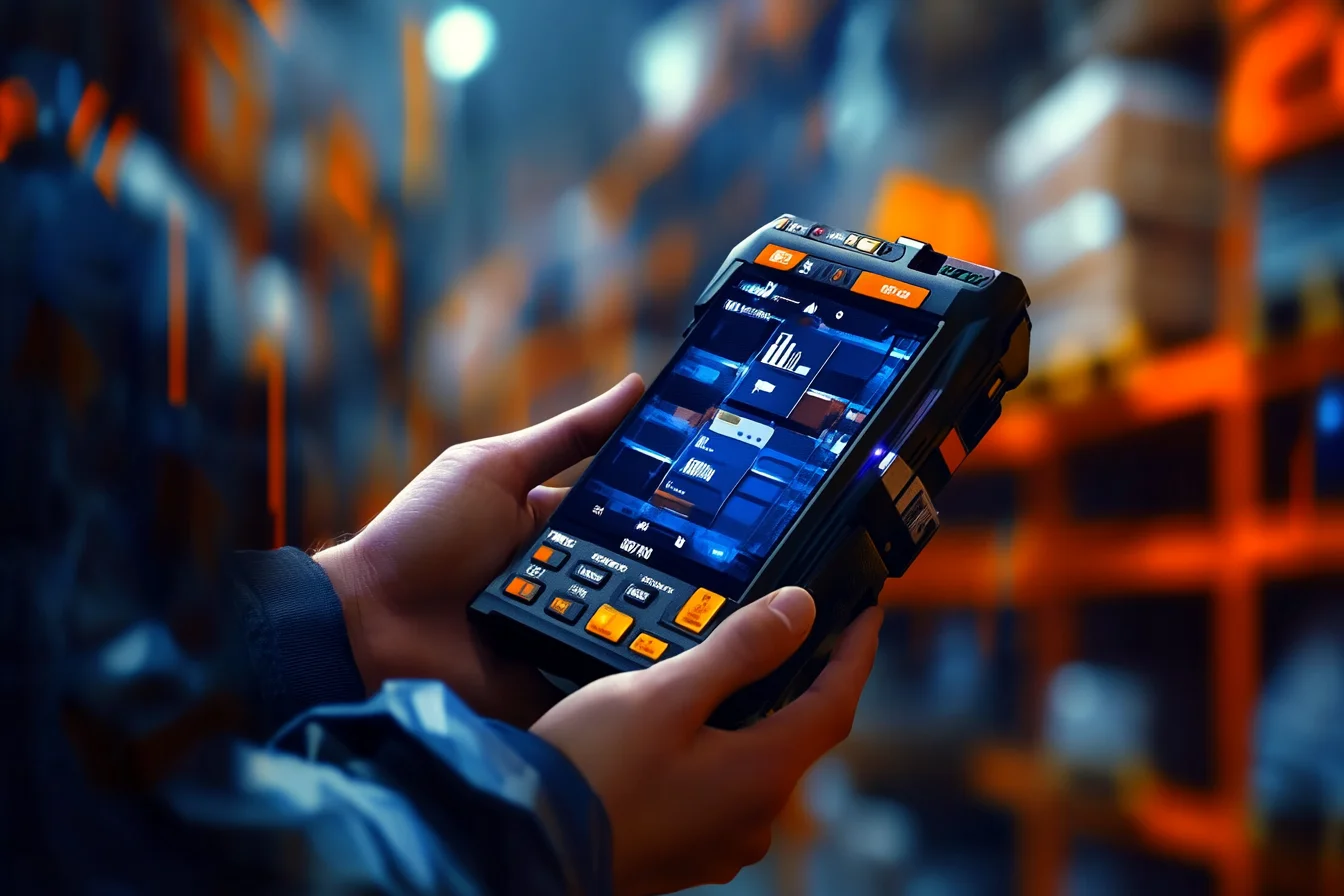
Terminal z Androidem obsługuje te same dane co stanowisko biurowe, a wymagania wobec urządzeń opisuje artykuł o aplikacji magazynowej na Androida. Zabezpieczenie transmisji i zasięg sieci omawia strona o terminalu radiowym w magazynie. Listę urządzeń, z którymi współpracuje Studio WMS.net, prezentuje serwis terminali radiowych SoftwareStudio.
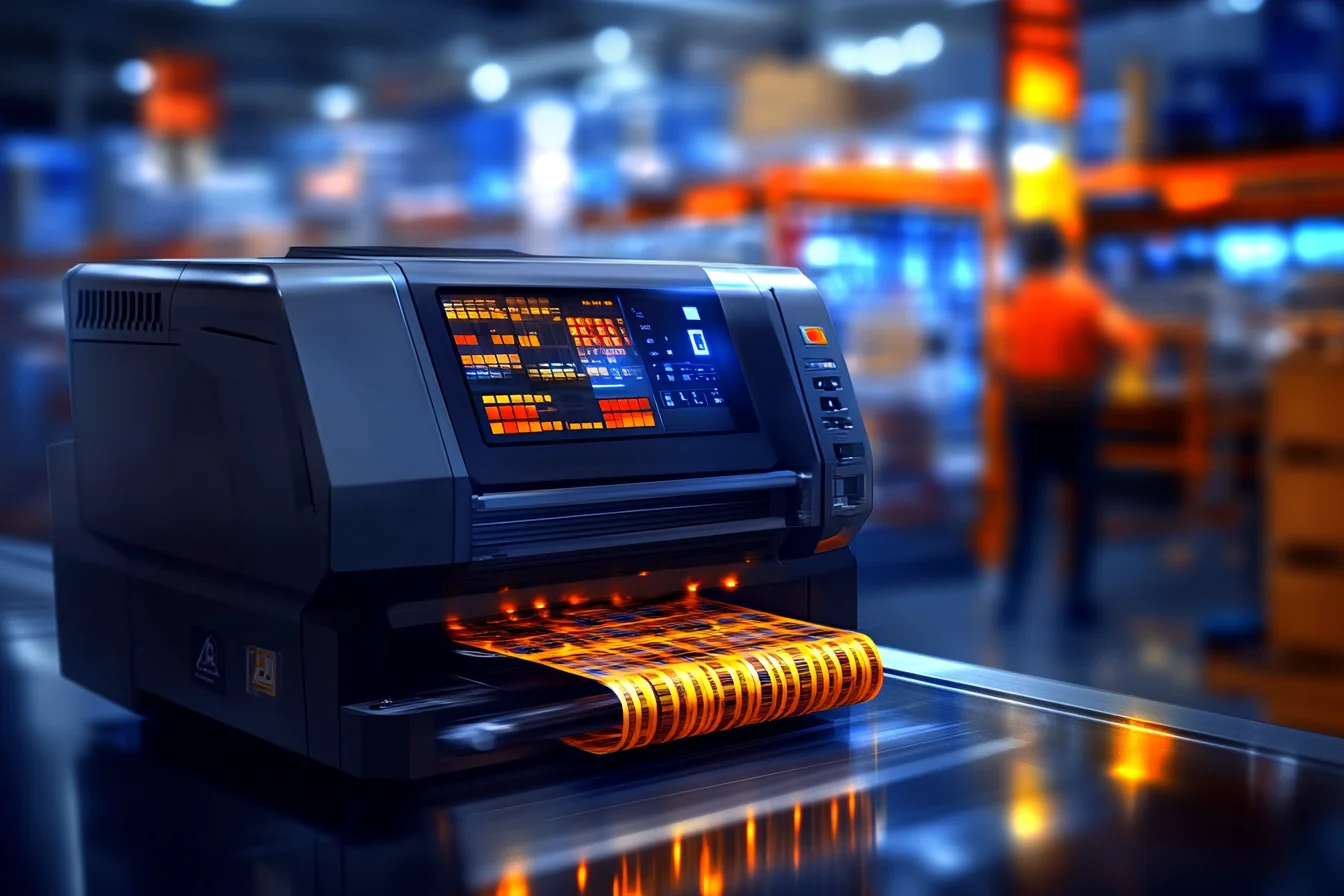
Drukarki etykiet dołączają do infrastruktury jako urządzenia sieciowe. Sterowanie odbywa się zwykle w języku poleceń drukarki (ZPL dla urządzeń Zebra), a etykietę składa serwer aplikacji na podstawie szablonu. Odporność na awarie zasilania jest równie ważna jak wydajność serwera: zasilacz UPS dla serwera bazy i przełączników pozwala zamknąć operacje bez uszkodzenia danych.
Bezpieczeństwo danych i kopie zapasowe
Uprawnienia i dziennik zdarzeń
Bezpieczeństwo zaczyna się od uprawnień przypisanych do ról, a nie do pojedynczych kont. Zmiana stanowiska pracownika nie wymaga wtedy przebudowy konfiguracji dostępu. Każda operacja na dokumencie lub stanie trafia do dziennika zdarzeń, który pozwala odtworzyć, kto i kiedy dokonał zmiany. Ogólne zasady bezpieczeństwa pracy na hali opisuje strona o bezpieczeństwie w magazynie.
Kopie zapasowe i odtwarzanie
Podstawowym mechanizmem ochrony danych są regularne kopie bazy: pełne oraz przyrostowe, wykonywane według harmonogramu i przechowywane poza serwerem produkcyjnym. Kopia dziennika transakcji pozwala odtworzyć stan z dokładnością do punktu w czasie. Przykład pokazuje kopię pełną oraz kopię dziennika, a na końcu weryfikację pliku. Nazwa bazy jest przykładowa.
-- przykład: kopia pełna, kopia dziennika transakcji i sprawdzenie kopii (nazwa bazy przykładowa)
BACKUP DATABASE Magazyn
    TO DISK = N'E:\Kopie\Magazyn_pelna.bak'
    WITH COMPRESSION, CHECKSUM, INIT;

BACKUP LOG Magazyn
    TO DISK = N'E:\Kopie\Magazyn_dziennik.trn'
    WITH COMPRESSION, CHECKSUM;

RESTORE VERIFYONLY
    FROM DISK = N'E:\Kopie\Magazyn_pelna.bak'
    WITH CHECKSUM;
Instrukcja RESTORE VERIFYONLY sprawdza spójność pliku, ale nie dowodzi, że dane da się odtworzyć na innym serwerze. Zasady wykonywania i odtwarzania kopii opisuje przegląd kopii zapasowych i odtwarzania baz SQL Server.
Reguła: kopię zapasową uznaje się za dobrą dopiero po udanym odtworzeniu. Same komunikaty o zakończonym tworzeniu kopii nie wystarczają, dlatego odtwarzanie na serwerze testowym wykonuje się okresowo.
Plan ciągłości działania
Plan ciągłości opiera się na dwóch parametrach: maksymalnym akceptowalnym czasie przestoju (RTO) i dopuszczalnej utracie danych (RPO). Od nich zależy częstotliwość kopii dziennika i to, czy potrzebna jest replikacja na serwer zapasowy. Parametry ustala się przed awarią, a nie w jej trakcie. Rozsądną praktyką bywa reguła trzech kopii w dwóch miejscach, z jedną kopią poza siedzibą firmy, oraz fizyczne rozdzielenie serwera produkcyjnego i zapasowego.
Etapy uruchomienia architektury
Architekturę uruchamia się w uporządkowanej kolejności, niezależnie od wybranego modelu aplikacji:
- Analiza infrastruktury - sprawdzenie serwera i sieci oraz liczby stanowisk wymagających dostępu.
- Wybór modelu aplikacji - klient-serwer albo webowy, zależnie od rozproszenia magazynów i zasobów IT.
- Baza i kopie - przygotowanie schematu i indeksów oraz harmonogramu kopii na serwerze produkcyjnym.
- Integracje i testy - połączenie z ERP przez API oraz próba wydajności pod docelowym obciążeniem.
Pełny przebieg projektu wraz z harmonogramem opisuje strona o wdrożeniu systemu WMS. Działanie systemu można sprawdzić w demonstracyjnym magazynie online bez instalacji.